跨境电商订单同步效率低?解析多平台库存数据打通的关键技术
多平台铺货的跨境电商卖家,几乎都经历过这样的场景:凌晨三点,某个爆款SKU在亚马逊和Shopify上同时售罄,但ERP系统里的库存数据还停留在两小时前。结果就是,超卖订单像雪片一样涌来,海外仓的拣货员对着缺货清单发愣,客服邮箱里塞满了消费者催单的邮件。这并非管理疏忽,而是订单同步环节存在技术断层——当销售渠道超过三个,库存数据就不再是“同步”问题,而是分布式系统的数据一致性问题。
为什么订单同步总在“拖后腿”
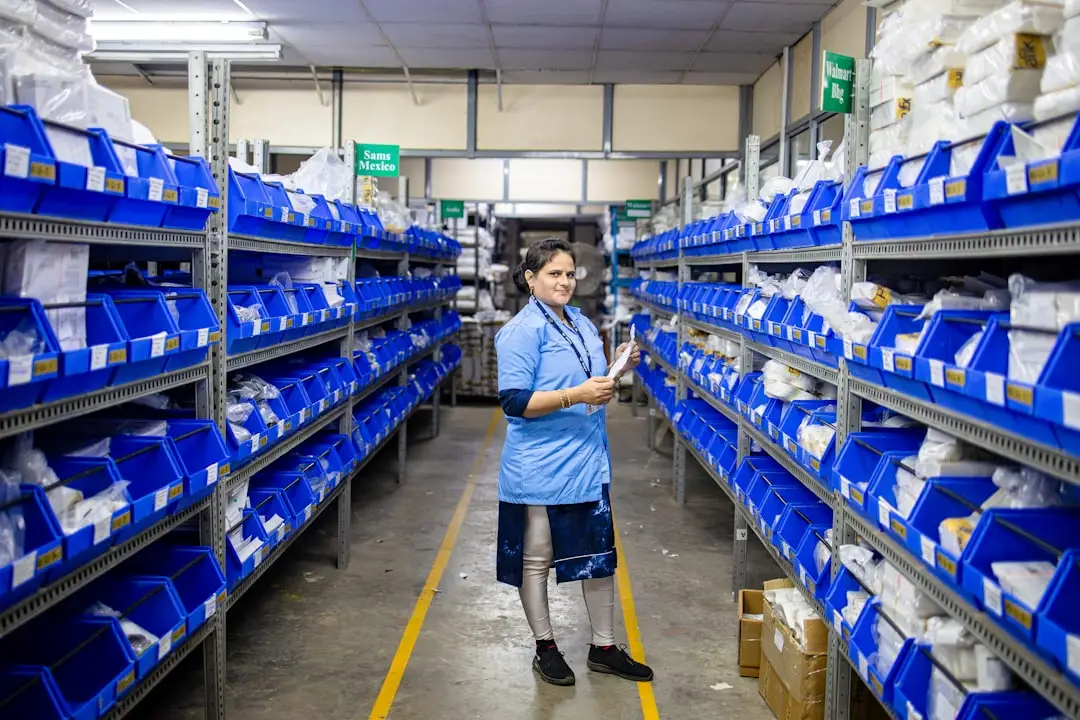
多数卖家的现状是:eBay用一套第三方工具,Amazon后台直连,独立站靠插件推送。每个渠道都有自己的库存扣减逻辑和延时机制。以某头部跨境电商卖家的实测数据为例,其日均订单量约1.2万单,分布在5个平台,平均每个SKU的库存变更需要经过“平台回调→中间件解析→ERP写入→海外仓WMS确认”四跳,耗时从40秒到15分钟不等。而真正可怕的不是延迟,是并发冲突——两个平台同时扣减同一个库存单元,处理不当就会产生负数库存。
更深层的问题在于,海外仓管理系统与销售前端的数据模型往往不兼容。海外仓关注的是物理库存(可售、在途、锁定),而电商平台关心的是逻辑库存(可售数量、预留数量)。如果中间层只是做简单的数值加减,没有处理“在途库存的可售化规则”和“平台间预留库存的互相抵消”,数据必然越跑越偏。
核心技术:事件驱动架构与幂等性设计
解决订单同步效率的关键,不是换一套更贵的ERP,而是重构数据流通的方式。事件驱动架构(EDA)是目前行业内验证过的主流方案——每个平台产生的订单、退款、库存调整,都作为独立事件推送到消息队列(如RabbitMQ或Kafka),再由统一消费者模块按SKU维度聚合。这套架构最大的优势在于解耦:即使某个海外仓接口响应缓慢,也不会阻塞其他渠道的订单写入。
但光有事件还不够,必须解决幂等性问题。网络抖动导致的重复推送,或者消费者取消订单后又重新下单,都会触发重复扣减。实践中的做法是给每条库存变更指令生成全局唯一ID,在写入数据库之前先查询该ID是否已处理过。这能避免至少90%以上的重复扣减错误。同时,建议将库存扣减操作从“同步调用”改为“异步对账+定时补偿”,例如每5分钟做一次全量比对,将差异数据单独标记出来人工复核。
实践方法:从接口对接走向数据中台
真正高效的库存管理,需要在销售层、调度层、仓储层之间建立统一的数据字典。具体落地时,可以分三步走:
- 第一步:梳理库存状态机。明确每个平台允许的库存状态(上架、停售、锁定),定义状态转换规则,比如Amazon的“FBA不可售”如何映射到自有海外仓的“质检中”状态。
- 第二步:建立库存共享池。所有渠道共享同一个“可用库存”逻辑视图,但每个渠道有独立的预留值(reserved)。当一个渠道发生售罄,系统自动检查其他渠道是否有未支付的预留订单,按时间戳释放或锁定。
- 第三步:引入分布式事务中间件。对于强一致场景(如秒杀、闪购),可以使用Seata或类似的AT模式;对于普通订单,则用TCC模式降低锁粒度,保证吞吐量。
某主营家居用品的深圳卖家在切换到上述架构后,订单同步的延迟从平均8分钟降至400毫秒以内,超卖率从每月0.7%降到了0.02%。其技术负责人反馈,最难的不是代码实现,而是说服运营团队改变“盯着ERP看库存”的习惯——现在他们看的是数据中台的实时仪表盘。
应用前景:从“同步”到“预测”的进化
当订单同步不再是瓶颈,跨境电商的竞争焦点会转向库存的前置预测。例如,通过分析各平台的历史销售速率和促销日历,系统自动在热销SKU的库存低于安全阈值时,生成补货建议,并将补货单直接推送给海外仓的采购模块。这意味着海外仓管理从被动响应升级为主动调度,库存周转率有望提升30%以上。
对于中小卖家,不必一步到位搭建完整的数据中台,可以先从打通“订单-库存-物流”三个核心表结构入手,选用开源的Apache Kafka或AWS SQS作为消息中间件。关键在于,从一开始就要避免“点对点接口”的短期思维——那只会让系统越改越乱。数据同步的本质,是让信息在正确的时间到达正确的位置,而技术只是手段,业务流程的标准化才是根基。